L’intelligence artificielle en finance porte deux images opposées. D’un côté, un empilement de code froid qui tamise des océans de données à la recherche d’un edge. De l’autre, un modèle fragile qui casse au premier changement de régime. Ces deux visions ont leur part de vérité, et l’écart entre elles est précisément l’espace où se joue aujourd’hui la compétition des investisseurs sérieux.
Ce que recouvre « l’IA en trading quantitatif »
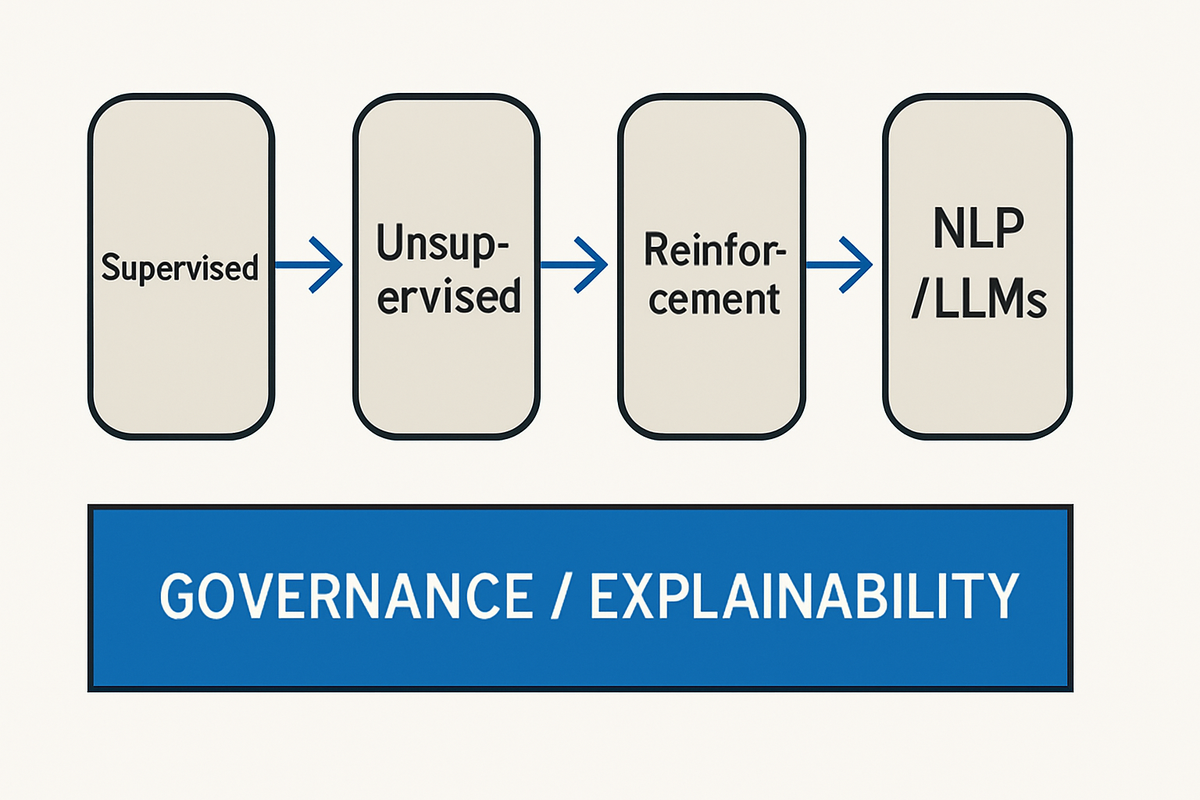
L’IA en trading quantitatif est une boîte à outils, pas un modèle unique. Elle couvre l’apprentissage supervisé qui relie des features aux rendements futurs, les méthodes non supervisées qui détectent des clusters ou des anomalies, et l’apprentissage par renforcement qui adapte les décisions en séquence. Elle intègre aussi des couches NLP et LLM qui lisent textes et données alternatives à l’échelle. Cette vue large est essentielle, car les méthodes interagissent et les effets de marché se manifestent au niveau du système.
Les modèles supervisés apprennent à partir d’étiquettes, par exemple les rendements du mois suivant ou la volatilité réalisée. Le travail commence par des features construites à partir des prix, des fondamentaux ou des flux. Les labels reflètent un objectif clair. Le détail de la conception des features et des labels décide même de la testabilité du modèle. Les guides de praticiens insistent dessus dans Financial Machine Learning d’AQR.
Les outils non supervisés mettent au jour la structure sans étiquettes. On peut, par exemple, regrouper des entreprises par comportement ou décomposer des moteurs de performance à travers les actifs. Ces méthodes orientent souvent l’agenda de recherche avant toute tentative de prévision.
L’apprentissage par renforcement est encore différent. Il convient aux contextes où le modèle agit, observe une réponse, puis agit à nouveau. L’exécution et la tenue de marché en sont des cas d’école. Dans cette boucle, la « meilleure action suivante » compte parfois plus qu’une prédiction brute. Les feuilles de route convergent vers des architectures hybrides, guidées par la connaissance. Elles injectent règles et savoir métier dans des apprenants gourmands en données.
Pourquoi une taxonomie vaut mieux que des mots‑valises
Une carte claire des méthodes protège de deux pièges. D’abord, utiliser un modèle prédictif là où un problème de contrôle s’impose produit des résultats faibles. Ensuite, déployer un modèle de langage là où un petit score linéaire suffit ajoute des coûts sans bénéfice. La taxonomie clarifie aussi où l’explicabilité est essentielle et comment l’obtenir.
L’explicabilité n’est pas un outil unique. Elle va de features transparentes à sens économique à l’attribution a posteriori et aux contraintes monotones. Les programmes de recherche sur la nouvelle génération du quant privilégient des chaînes automatisées et explicables, car elles relient l’art du modèle au contrôle. Ce pont devient décisif quand les signaux se saturent et que les exigences de gouvernance montent.
Pourquoi c’est clé maintenant — données, calcul et nouvelle classe de signaux
L’échelle et l’accès ont changé. Textes, transcripts et données alternatives sont désormais ingérés et analysés à une cadence industrielle. La capacité des modèles transforme des narratifs flous en signaux mesurables. Les points de vue du secteur décrivent comment LLMs et machine learning étendent l’extraction de signaux textuels et aident à bâtir des paniers thématiques entre secteurs et régions. Les workflows homme + machine sont aussi présentés comme un avantage concurrentiel, car la vitesse seule ne suffit pas.
Le contexte de marché a lui aussi évolué. Les régulateurs et les banques centrales voient l’IA se diffuser dans l’intermédiation et la gestion d’actifs, avec des effets qui dépassent les fonds pris isolément. Une vaste enquête de la Banque des règlements internationaux cartographie ces changements macro et systémiques. Elle alerte également sur des risques qui croissent avec l’adoption.
Résultat : la concurrence entre équipes change de nature. Données, puissance de calcul et conception des workflows redéfinissent la frontière de ce qui est faisable en recherche. Les maisons qui connectent la recherche à la production avec des contrôles testent plus vite, échouent de façon plus sûre et livrent des stratégies qui tiennent en conditions réelles.
Techniques et architectures clés employées dans les stratégies quant
Le travail commence par les features et les labels. Les praticiens mettent en garde contre l’ingénierie astucieuse sans histoire économique. Ils exigent une validation croisée qui respecte le temps et la structure de marché. Ils recommandent aussi d’éviter le data‑mining via des découpes propres, des benchmarks pertinents et des tailles d’effet compatibles avec la réalité. Ces conseils sont exposés dans Financial Machine Learning d’AQR.
L’automatisation gagne la pile. Les frameworks AutoML peuvent proposer des modèles et hyperparamètres, puis les classer sur des métriques hors échantillon sous garde‑fous. Les feuilles de route vers un « Quant 4.0 » pointent l’assemblage automatisé de modèles, l’IA explicable et des hybrides guidés par la connaissance comme trajectoire. L’objectif n’est pas une boîte noire. C’est une chaîne auditable de bout en bout.
L’apprentissage par renforcement s’impose dans l’exécution et la planification des ordres. L’environnement est partiellement observé, changeant et bruité. D’où l’importance d’états robustes et de politiques conservatrices. Dans ces zones, la récompense se formule souvent en shortfall d’implémentation ou en slippage, pas en alpha absolu.
Le NLP et les LLMs étendent l’univers des signaux. Les équipes scorent le langage des documents et des conférences de résultats, étiquettent les thèmes et cartographient les entités dans le temps pour suivre l’évolution des dynamiques. Les praticiens indiquent que ces modèles permettent la construction thématique et offrent de nouveaux prismes de portefeuille. Le contrôle humain reste indispensable pour des vérifications de bon sens.
| Technique / Architecture | Finalité principale | Garde-fous clés |
|---|---|---|
| Ingénierie des features/labels | Définir des problèmes apprenables | Intuition économique, tests de stationnarité |
| Validation croisée (sensible au temps) | Évaluation honnête du modèle | Découpes purgées/embargo, fenêtres roulantes |
| Ensembles/empilement de modèles | Prédiction robuste | Diversité des apprenants, pondération hors échantillon |
| Apprentissage par renforcement | Exécution et contrôle | Récompenses conservatrices, limites de risque |
| NLP/LLMs | Signaux textuels et données alternatives | Lexiques métiers, revue humaine |
| Hybrides guidés par la connaissance | Stabilité et interprétabilité | Contraintes, couches d’explicabilité |
| Pipelines AutoML | Vitesse et couverture | Traces d’audit, reproductibilité |
Pièges et idées reçues fréquents chez les praticiens
Plus de données ne corrige pas une mauvaise conception. Si les labels laissent fuiter de l’information future ou si les features incorporent un biais d’anticipation, des jeux plus volumineux ne feront qu’affiner l’erreur. Les enquêtes auprès de praticiens documentent la fuite de données et les changements de régime comme modes d’échec récurrents. Elles recommandent une hygiène de backtest rigoureuse et un suivi attentif pour éviter les faux edges.
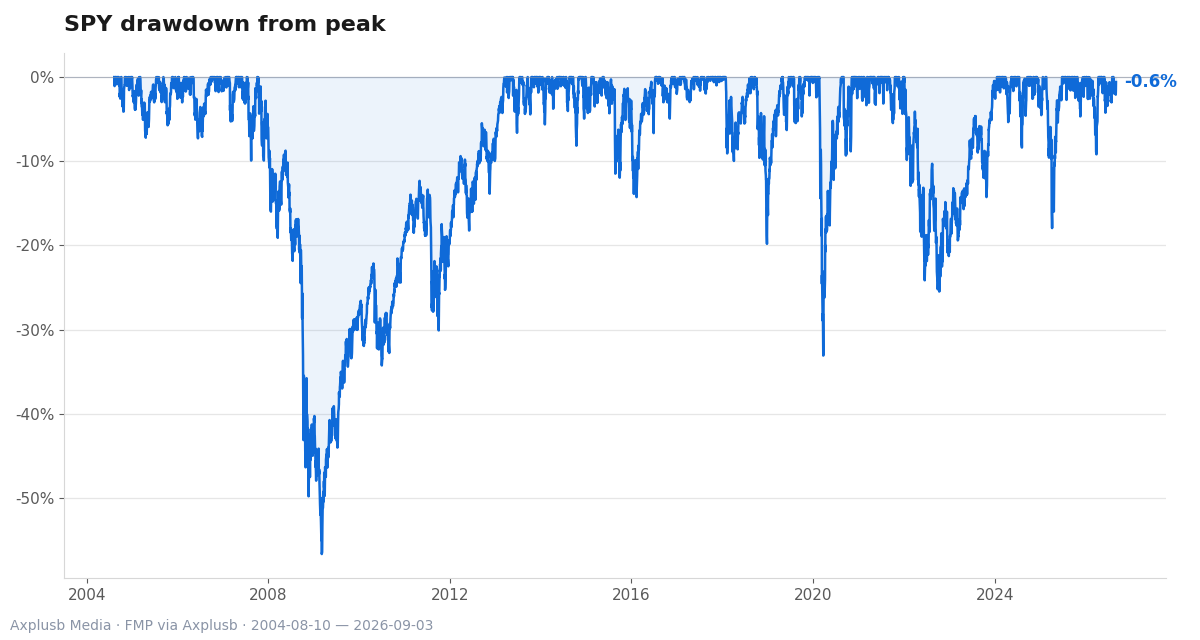
Le changement de régime est le tueur discret. Des signaux construits dans un climat de marché donné peuvent se dégrader vite lorsque la liquidité, la politique ou l’encombrement évoluent. Les retours d’expérience préconisent une validation sensible aux régimes et des stress tests qui sondent les comportements changeants avant de risquer du capital.
La complexité exerce aussi une séduction. Un modèle profond peut éblouir par son fit in‑sample, mais un simple score linéaire, adossé à une intuition solide, tient souvent mieux hors échantillon. C’est là que la discipline de test paie. Les découpes en coupe transversale et en séries temporelles doivent refléter la manière dont la stratégie traitera en réel.
Si vous doutez que vos tests reflètent la réalité, commencez par des méthodes de backtesting plus robustes. Nous détaillons des étapes concrètes et des chemins de code dans Exploiter le machine learning pour améliorer le backtesting des stratégies quantitatives.
Quand l’incertitude monte, mettez sous pression vos hypothèses et fenêtres de données avec les méthodes de Techniques avancées de backtesting pour des stratégies quantitatives en période d'incertitude.
Risques systémiques et conséquences de marché : mimétisme, concentration et déficit d’explicabilité
Quand beaucoup d’acteurs font tourner des modèles semblables sur des données similaires, l’encombrement s’accumule. Le working paper de la BIS sur l’IA en finance alerte sur un mimétisme des modèles capable d’amplifier les queues de distribution et de stresser la liquidité. Ce n’est pas une inquiétude lointaine. C’est une propriété connue des systèmes adaptatifs qui apprennent de signaux partagés.
La concentration du risque grandit aussi hors de la salle de marché. Les fournisseurs de calcul, de cloud et de données forment une pile étroite dont dépendent de nombreuses maisons. Cela peut devenir un point de défaillance unique. Les décideurs publics suivent ces maillons, car la résilience inclut désormais les dépendances tierces et les modèles partagés.
L’explicabilité compte au‑delà du marketing. Lorsque des modèles pilotent capital et risque, les superviseurs veulent savoir comment les décisions sont prises et comment les contester. La revue de l’OCDE sur l’IA et la finance met en avant l’explicabilité, la gouvernance et la coordination transfrontalière comme thèmes politiques centraux.
Les réponses de gouvernance suivent le risque. Les standards d’audit, de documentation et de validation des modèles montent. Ils façonnent la façon dont la recherche passe en production. Les maisons qui intègrent l’explicabilité dans la chaîne peuvent satisfaire clients et régulateurs sans brider l’innovation.
Adoption réelle : exemples de praticiens et études de cas
L’adoption n’a rien de théorique. De grands gérants d’actifs déclarent utiliser ML et LLMs pour exploiter les textes, construire des thématiques et mettre à l’échelle leurs workflows de recherche. Ils conservent une supervision humaine dans le processus. Ce workflow relève autant de l’infrastructure et de l’accès aux données que du choix des modèles.
Les communications publiques indiquent aussi comment les outils s’intègrent. Un exemple est un moteur NLP orienté « thèmes » utilisé pour éclairer des univers d’investissement et des scores dans un cadre de conseil. La divulgation en tant que telle compte. Elle montre le degré de transparence et de contrôle qui encadre le rôle du modèle dans le processus.
Les études de cas insistent sur le fait que l’intégration est la partie difficile. Gouvernance des données, gestion des versions et monitoring doivent être en place pour que les modèles créent de la valeur à l’échelle des équipes. Quand ces fondamentaux faiblissent, même des modèles ingénieux sous‑performent ou génèrent un risque opérationnel.
Pour les investisseurs hors des plus grandes maisons, la leçon est simple. Commencez par des cas d’usage clairs, là où un avantage de données existe, et alignez le périmètre du modèle sur la maturité de la gouvernance. La complexité viendra ensuite si la première boucle se révèle robuste.
Contre‑arguments et limites : où l’IA peut ne pas créer d’alpha durable
Les edges s’érodent. Les marchés s’adaptent et transforment une régularité découverte en bruit dès que les conditions changent. Les retours d’expérience sur l’IA en quant rappellent que nombre de signaux sont encombrés. Un court historique live confond facilement chance et compétence. Dans certains domaines, des modèles simples, reliés à des mécanismes économiques durs, l’emportent encore.
Les données ne sont pas neutres. Des biais dans les inputs et les labels peuvent déformer les prédictions et produire des résultats inéquitables ou instables. Les travaux de politique publique soulignent la nécessité de tester les biais. Ils appellent aussi à l’explicabilité lorsque des résultats intéressent les régulateurs.
Le coût compte également. Les modèles sophistiqués exigent calcul, données et ingénierie que de plus petites équipes ne peuvent supporter. Une fois intégrés les coûts de recherche, de suivi et de contrôle, une configuration plus légère avec une validation serrée peut offrir un meilleur résultat ajusté du risque.
Boîte à outils pratique — validation, suivi et check‑list de gouvernance pour les équipes
Voici une check‑list compacte issue de la pratique. Servez‑vous‑en pour structurer la recherche et sécuriser la production.
- Définir des features et labels avec une histoire économique, et tester la stationnarité.
- Utiliser une validation croisée sensible au temps avec purge et embargo pour éviter les fuites.
- Se comparer à des modèles simples et transparents avant d’ajouter de la complexité.
- Lancer des backtests hors échantillon et sensibles aux régimes avec fenêtres roulantes.
- Stress tester avec données synthétiques et perturbations pour sonder la fragilité.
- Ajouter des couches d’explicabilité et des contraintes monotones ou de forme quand elles ont du sens.
- Surveiller en live le drift, la qualité des données et la performance, avec alertes.
- Garder un humain dans la boucle pour les dérogations, surtout en exécution et en cas extrêmes.
- Tout documenter: lignée des données, paramètres et journaux de décision.
Pour des détails de mise en œuvre, voir Exploiter le machine learning pour améliorer le backtesting des stratégies quantitatives.
Si vos marchés bougent vite, couplez‑la avec Techniques avancées de backtesting pour des stratégies quantitatives en période d'incertitude pour concevoir vos stress.
Les éléments de gouvernance font écho aux recommandations de politique publique. La revue de l’OCDE sur l’IA et la finance appelle à l’auditabilité, à la validation des modèles et à la gouvernance des données à travers les frontières. Intégrer ces standards dans la chaîne de recherche réduit les frictions avec clients et régulateurs.
N’oubliez pas le facteur humain en conditions réelles. Les emballements comportementaux peuvent saboter un modèle pourtant bien testé quand la volatilité explose. Si votre dispositif doit résister au stress, revisitez les garde‑fous de Le rôle de la psychologie des investisseurs en marchés volatils : stratégies de résilience et adaptez votre tableau de bord.
Évaluez la discipline réelle de votre portefeuille. Passez une stratégie au crible de cette liste et notez ce qui doit évoluer ce trimestre.
Conclusion et perspectives — ce que praticiens et autorités doivent surveiller
Trois forces vont façonner le domaine. Sur le plan technique, attendez‑vous à plus de pipelines automatisés, à une meilleure explicabilité et à des hybrides guidés par la connaissance qui mêlent règles et données. Sur le plan organisationnel, les maisons gagnantes marieront recherche rapide, mise à l’échelle, monitoring et jalons clairs vers la production.
Au niveau systémique, la supervision s’intensifiera avec la diffusion. L’enquête de la BIS sur l’IA en finance pointe le mimétisme et la concentration comme des sujets déjà présents. La revue de l’OCDE cadre la gouvernance en faveur de la stabilité et de l’alignement transfrontalier. Ces prismes guideront la politique publique et façonneront les incitations auxquelles font face les bâtisseurs de modèles.
La frontière n’est pas un modèle, c’est un processus. Les équipes qui conjuguent intuition économique, validation vigilante et automatisation explicable trouveront des edges plus durables. Les autres découvriront qu’en marchés, l’ingéniosité est commune, la robustesse est rare.
Commencez petit, mesurez dur, et concevez pour le changement. C’est le chemin vers une pile IA qui résiste au contact des marchés live.
À lire également
- Exploiter le machine learning pour améliorer le backtesting des stratégies quantitatives
- Techniques avancées de backtesting pour des stratégies quantitatives en période d'incertitude
- Le rôle de la psychologie des investisseurs en marchés volatils : stratégies de résilience