Le machine learning a promis des signaux plus nets et davantage de données. Il a aussi rendu le backtesting à la fois plus difficile et plus crucial. Ces méthodes ne s’ajoutent pas aux tests classiques, elles redéfinissent ce que « validé » veut dire.
Définir le backtesting ML dans les stratégies quantitatives
Faire du backtesting avec apprentissage automatique remplace une règle fixe par une cartographie adaptative des entrées vers les transactions. Le modèle apprend des schémas sur l’historique, puis met à jour, choisit des hyperparamètres et se réentraîne parfois de façon roulante. Cette boucle casse la simple découpe in‑sample versus out‑of‑sample sur laquelle reposaient les tests de facteurs. Elle exige une validation sensible au temps et un contrôle rigoureux du choix de modèle.
Un large tour d’horizon des pratiques le souligne. En finance, les échantillons sont courts, les signaux faibles et les régimes changent. C’est pourquoi l’évaluation walk‑forward, les fenêtres roulantes et la régularisation apparaissent comme des recommandations centrales dans l’aperçu d’AQR des pratiques ML en finance, qui insiste aussi sur la contrainte de petites données à laquelle font face la plupart des investisseurs L’aperçu d’AQR sur l’apprentissage automatique en finance.
La validation inclut aussi un coût de sélection. Nous testons de nombreuses idées de modèles, d’hyperparamètres et de variables, puis nous gardons la meilleure. La littérature sur la Probability of Backtest Overfitting (PBO) formalise ce risque et propose des moyens de le mesurer. Elle requalifie aussi la durée du backtest et la conception des partitions en éléments du modèle lui‑même, pas en choix neutres.
Si vous travaillez sur la rotation de signaux, le défi est concret. Une règle qui semble stable peut n’être qu’un artefact de sélection, pas un avantage informationnel. Voyez comment nous avons géré cette tension dans Exploiter le machine learning pour optimiser les rotations d’ETF.
Pourquoi c’est crucial maintenant : données, calcul et complexité des modèles
Deux tendances renforcent l’urgence. Premièrement, l’adoption est large dans les politiques publiques et les marchés, ce qui élève l’exigence de gouvernance. Une enquête de banque centrale documente l’usage étendu de l’IA, ainsi que des préoccupations sur la qualité et la représentativité des données et sur la gestion du risque de modèle Document de travail n° 930 de la BRI sur le big data et le machine learning.
Deuxièmement, le menu de données et le budget de calcul ont grossi, mais l’échantillon effectif de nombreux signaux reste court. L’enquête d’AQR note que les applications financières affrontent souvent de petites données et des étiquettes bruyantes, ce qui impose de la rigueur en validation croisée et dans le choix des modèles selon l’aperçu d’AQR sur l’apprentissage automatique en finance.
Les praticiens confirment cette tension. En macro, les équipes mutualisent les coupes transversales, s’appuient sur des a priori métiers et recourent à la régularisation pour empêcher les modèles d’apprendre le bruit. Ce cadre s’applique aussi au backtesting, car les choix de validation doivent épouser la forme des données et l’histoire économique.
Le backtesting se situe donc au croisement du modélisme et de la gouvernance. La posture statistique doit être stricte et la documentation doit voyager avec le code. Leur combinaison évite que la recherche ne dérive en un run chanceux et non reproductible.
Les principaux modes d’échec : surapprentissage, data‑snooping, biais de survie et risque de modèle
Le surapprentissage est la vedette. Essayez assez de modèles sur un échantillon fini et l’un semblera excellent par hasard. Le cadre de la Probability of Backtest Overfitting définit ce problème et le relie à la conception des partitions de test. Il motive aussi des outils comme la validation croisée respectueuse du temps et des métriques de performance dégonflées.
Le data‑snooping est le cousin du surapprentissage. On jette un œil, puis on adapte le test aux données, souvent sans tracer cette étape. Ajouter ou retirer des variables après chaque run amplifie la sélection sur le bruit. Les approches formelles recommandent des méthodes qui tiennent compte du nombre d’essais, pas seulement du score du vainqueur.
Le biais de survie et la conception de l’échantillon complètent le tableau. Retirer les tickers disparus ou utiliser un indice qui se reconstitue en silence gonfle artificiellement la performance passée. La faible longueur de l’échantillon effectif aggrave le tout, car quelques événements trimestriels peuvent générer l’essentiel de l’avantage mesuré.
Le risque de modèle lie ces points en un sujet de gouvernance. L’enquête de la BRI souligne des préoccupations sur la qualité et la représentativité des données, qui alimentent les mêmes modes d’échec en backtests Document de travail n° 930 de la BRI sur le big data et le machine learning.
La boîte à outils du praticien : walk‑forward, CV roulante, pénalisation et dégonflage
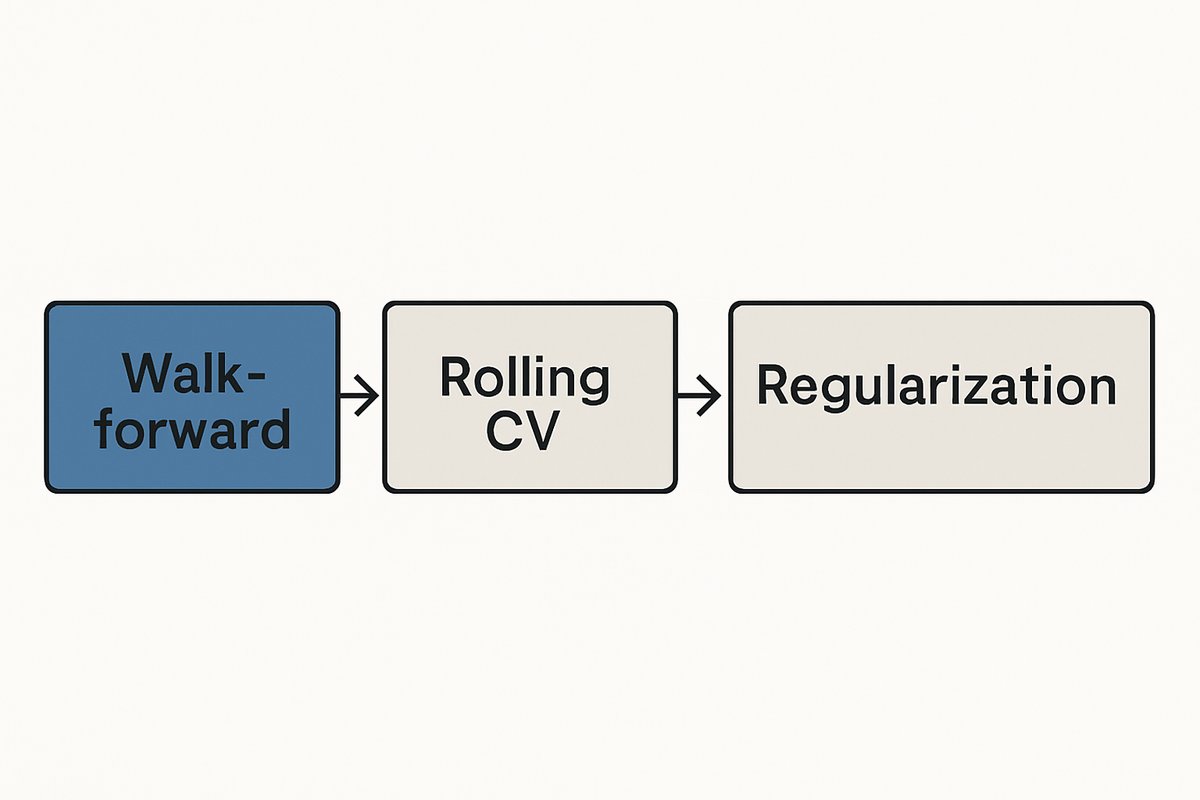
Un backtesting robuste commence par la découpe. Un dispositif roulant ou walk‑forward entraîne sur une fenêtre mobile, teste sur la tranche suivante, puis décale à nouveau. L’enquête d’AQR décrit cela comme un choix par défaut pragmatique compte tenu de la petite taille des échantillons et du caractère non stationnaire des données financières selon l’aperçu d’AQR sur l’apprentissage automatique en finance.
La validation croisée sensible au temps prolonge l’idée. Au lieu de plis aléatoires, chaque pli respecte l’ordre temporel et utilise le passé pour prédire le futur. Cela aligne l’apprentissage sur la réalité et limite le biais optimiste dû aux fuites. Cela offre aussi plusieurs contrôles out‑of‑sample pour une même famille de modèles.
La pénalisation s’impose à l’étape de sélection. La régularisation rétrécit les paramètres instables et récompense les explications plus simples qui s’ajustent encore aux données. Lorsque nous présentons un Sharpe ou un taux de réussite, une version dégonflée ou pénalisée reconnaît la recherche de modèles et le bruit. L’objectif n’est pas de tout déprimer, mais de rétrograder les victoires trop faciles.
Voici une carte compacte de la boîte à outils.
| Technique | Rôle dans le backtesting | Référence principale |
|---|---|---|
| Évaluation walk‑forward | Reproduire la cadence de réentraînement et de déploiement en réel | Enquête AQR sur les configurations roulantes |
| Validation croisée sensible au temps | Réduire les fuites et le biais optimiste | Enquête AQR sur la CV en petite taille d’échantillon |
| Régularisation | Contrôler la variance et rétrécir les ajustements instables | Enquête AQR sur la régularisation |
| Métriques de performance dégonflées | Tenir compte de l’inflation due à la recherche de modèle | Cadre PBO et travaux associés |
Si votre stratégie doit s’adapter à des chocs macro rapides, cette structure compte. Nous avons exploré des garde‑fous similaires dans Techniques avancées de backtesting pour des stratégies quantitatives en période d’incertitude.
Correctifs statistiques avancés : CSCV, pénalités de covariance et ajustements TLS
La Combinatorially‑Symmetric Cross‑Validation (CSCV) a été conçue pour estimer la probabilité qu’un backtest soit le meilleur uniquement par chance. Elle construit de multiples découpes respectueuses du temps, évalue chaque candidat puis mesure la fréquence à laquelle le gagnant échoue hors échantillon. Ce ratio approche la Probability of Backtest Overfitting telle que définie dans les travaux fondateurs.
Les corrections par pénalité de covariance s’attaquent à l’optimisme des performances estimées. L’idée est de soustraire une pénalité qui croît avec la complexité du modèle et le bruit des données. Les éléments empiriques suggèrent que ces pénalités, associées à des ajustements de type Total Least Squares, réduisent l’écart entre résultats in‑sample et en avant. Elles ne sauvent pas une mauvaise idée, elles rendent le score plus honnête.
Ces méthodes sont légères à mettre en œuvre. La CSCV se superpose à un flux de travail roulant. Les estimations pénalisées peuvent être publiées à côté des chiffres bruts comme règle permanente. Le principal coût est le temps de calcul, bien moindre qu’un douloureux repli en réel.
Enfin, elles enseignent l’humilité. Si le Sharpe dégonflé tombe sous votre seuil, traitez l’avantage comme non prouvé. Cette décision coûte moins cher sur le papier qu’en production.
Données synthétiques et stress tests génératifs : promesses et limites
Les modèles génératifs offrent un autre regard. Une étude récente propose d’utiliser un GAN avec des modèles de séquences pour créer des trajectoires de prix synthétiques, puis tester une stratégie sur ces histoires alternatives pour détecter le surapprentissage une approche de backtesting synthétique basée sur des GAN sur arXiv.
L’intuition est simple. Si une stratégie ne gagne que sur la trajectoire observée, elle peut échouer sur des trajectoires voisines tirées d’une distribution apprise. Un ensemble diversifié d’histoires synthétiques peut révéler cette fragilité. Il peut aussi faire apparaître des cas où le modèle dépend trop d’une seule phase de marché.
Il y a des limites. Les données synthétiques ne valent que ce que le modèle et l’échantillon d’entraînement permettent. Les analyses sectorielles avertissent que ces générateurs peuvent manquer de vrais changements de régime et de la complexité de la microstructure, de sorte qu’ils ne lèvent pas l’incertitude centrale de la prévision. Traitez‑les comme des stress tests, pas comme des substituts au vrai out‑of‑sample.
Adoptez des règles claires. Spécifiez les statistiques que le GAN doit respecter et les modes d’échec à sonder. Présentez les résultats avec la même prudence que pour un petit backtest. Un succès sur des données factices est une condition nécessaire, pas suffisante.
Prisme institutionnel : gouvernance, qualité des données et contrôles du risque de modèle
Le backtesting vit dans une pile de gouvernance. Les banques centrales rapportent un vif intérêt pour le ML, tout en citant la qualité et la représentativité des données et la supervision comme préoccupations clés de risque de modèle Document de travail n° 930 de la BRI sur le big data et le machine learning.
Cette liste se traduit bien côté gestion. La traçabilité indique comment les données ont été construites et révisées. La représentativité interroge si l’échantillon d’entraînement couvre l’usage visé. La supervision exige un dossier clair des versions de modèles, des choix de paramètres et des résultats de validation.
Les praticiens plébiscitent aussi les a priori métiers. En macro ML, les équipes combinent des coupes transversales, encodent la structure économique et appliquent de la régularisation pour réduire le surapprentissage dans des données clairsemées. Le message pour le backtesting est d’écrire l’a priori dans le design, pas seulement dans le modèle. Vos découpes, pénalités et métriques doivent refléter le fonctionnement attendu du signal.
Ce n’est pas de la paperasse. Une chaîne propre et un plan de validation écrit arrêtent la dérive silencieuse du data‑snooping et de la sélection sur la variable dépendante. Ils aident aussi quand il faut expliquer un repli devant un comité des risques.
Évidence empirique et retours de praticiens
Le fil conducteur des études et de la pratique est cohérent. L’enquête d’AQR documente que fenêtres roulantes, tests walk‑forward et régularisation sont des outils standards du ML financier, parce que les données sont courtes et non stationnaires selon l’aperçu d’AQR sur l’apprentissage automatique en finance.
En macro, les guides de praticiens rapportent que mutualiser les coupes transversales et intégrer des a priori métiers aident face aux étiquettes rares et au surapprentissage. Ces choix atténuent aussi l’optimisme du backtest, car ils restreignent l’espace des hypothèses. On obtient moins de degrés de liberté pour la même exposition économique.
Les méthodes formelles ajoutent de la puissance. Les travaux sur les pénalités de covariance et les ajustements associés montrent des gains empiriques en refermant l’écart entre in‑sample et out‑of‑sample. Et l’approche par GAN illustre comment des trajectoires synthétiques révèlent une stratégie qui ne gagne que parce qu’une histoire unique a coopéré une approche de backtesting synthétique basée sur des GAN sur arXiv.
Aucune ne supprime l’incertitude. Elles changent le taux de base et donnent des chances plus honnêtes. C’est ce que doit faire un backtest.
Contre‑arguments et limites sobres : pas de remède miracle aux changements de régime
La tentation d’un correctif final est forte. Il n’y en a pas. Des histoires synthétiques ne peuvent pas anticiper des ruptures structurelles jamais vues dans l’entraînement. Elles peinent aussi avec des détails de microstructure qui comptent en exécution réelle.
Les pénalités et la validation croisée ne créent pas d’information. Elles ajustent seulement notre propension à trouver des motifs inexistants. Même la CSCV et une probabilité estimée faible de surapprentissage ne garantissent pas l’avenir. Elles parlent du test, pas du prochain régime.
Les préoccupations institutionnelles ne sont pas décoratives. L’enquête de la BRI rappelle que qualité des données et gouvernance sont des risques de premier ordre, pas des pensées secondaires Document de travail n° 930 de la BRI sur le big data et le machine learning.
Gardez donc un ton modeste. Traitez tout avantage revendiqué comme une hypothèse en liberté conditionnelle. Il gagne la confiance en survivant au temps, à de nouvelles données et à des variantes sévères de votre test.
Conclusions pratiques : une check‑list opérationnelle pour les backtests ML
Que doit faire un desk la semaine prochaine. La liste ci‑dessous mise sur la répétition plutôt que sur le mystère. C’est volontaire.
- Imposer un dispositif walk‑forward avec fenêtres roulantes qui reflètent votre cadence de réentraînement en réel, en ligne avec l’enquête AQR sur le ML financier selon l’aperçu d’AQR sur l’apprentissage automatique en finance.
- Utiliser une validation croisée sensible au temps plutôt que des plis aléatoires. Envisager la CSCV quand vous avez besoin d’une probabilité de surapprentissage pour la sélection et le reporting.
- Appliquer la régularisation à l’entraînement et publier des performances dégonflées à côté des chiffres bruts. Faire de la pénalité un défaut, pas une arrière‑pensée.
- Soumettre la stratégie à des stress tests avec des trajectoires synthétiques issues d’un générateur discipliné. Considérer les succès comme nécessaires, en notant qu’un GAN ne modélise pas les ruptures de régime inconnues une approche de backtesting synthétique basée sur des GAN sur arXiv.
- Formaliser la gouvernance des données. Suivre la traçabilité, la représentativité et l’historique des révisions, conformément aux préoccupations institutionnelles de risque de modèle Document de travail n° 930 de la BRI sur le big data et le machine learning.
- Tenir une note de validation vivante. Journaliser versions de modèles, hyperparamètres, structure des plis et logique de sélection, et lier cela aux notes de déploiement.
- Pré‑enregistrer la règle de sélection lorsque possible. Décider avant de voir le chiffre quelle métrique et quelle pénalité gouvernent le go/no‑go.
- Réexaminer coûts, slippage et microstructure à chaque roll. Les mettre à jour avec la même rigueur que le modèle.
- Lancer un backtest fantôme post‑déploiement qui compare résultats réels et synthétiques. Utiliser l’écart comme déclencheur d’une revue de design.
- Former l’équipe aux modes d’échec. Faire du surapprentissage et du data‑snooping des éléments de l’onboarding et d’exercices périodiques.
Testez la discipline réelle de votre portefeuille. Passez votre meilleure idée au tamis de cette liste, puis laissez décanter.
Si votre processus touche à la rotation cross‑asset ou aux signaux macro, voyez comment nous avons appliqué des contrôles similaires dans Stratégies quantitatives de rotation d’ETF : s’adapter aux pressions inflationnistes.
Une note de cadence pour finir. Mettez ces contrôles au calendrier, pas à l’humeur. La date impose la sobriété quand l’optimisme s’emballe.
CTA : Rendez un backtest plus exigeant cette semaine, puis faites‑en votre nouvelle norme.
À lire également
- Techniques avancées de backtesting pour des stratégies quantitatives en période d’incertitude
- Exploiter le machine learning pour optimiser les rotations d’ETF
- Stratégies quantitatives de rotation d’ETF : s’adapter aux pressions inflationnistes